Firecrawl
为智能体搜索和提取网页内容,把资料转换为 Markdown、结构化 JSON 或截图。
Firecrawl 提供面向 AI 应用的网页搜索与内容提取接口,可把网页整理为 Markdown、HTML 或结构化数据,适合为研究、知识库和内容检查准备输入。
可以用来完成:整理官方文档、提取产品参数、检查自有内容目录。
Firecrawl 能做什么
先区分任务:查找网页用搜索,读取指定页面用抓取,发现站内地址用 Map,处理一定范围的多页内容用 Crawl。不同操作的结果与费用口径并不相同。
它帮助获取和整理网页内容,后续事实判断、分类与报告仍需应用或人员完成。应限定可访问站点、路径与页数,先检查样本是否提取完整。
提取可处理的网页内容
将指定 URL 转成 Markdown、HTML 等格式,减少把导航和页面结构直接交给模型。
按字段获取结构化结果
通过 JSON 等输出方式整理目标信息,适合后续校验和入库。
发现与处理一组页面
Map 用于寻找地址,Crawl 用于按范围抓取,帮助组织多页资料。
接入研究与智能体流程
通过 API、SDK 等把网页内容作为应用上下文,并保留来源与提取状态。
- 核心用途
- 网页搜索、单页提取、地址发现和范围抓取。
- 可完成的工作
- 整理官方文档、提取产品参数、检查自有内容目录。
- 如何开始
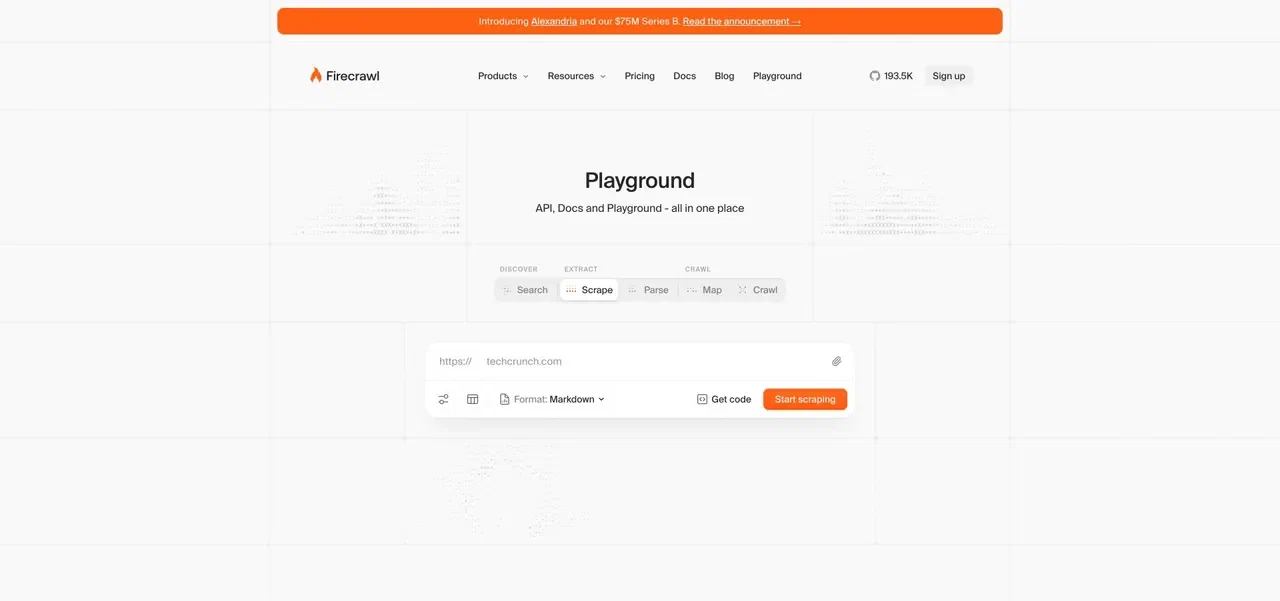
- 先在 Playground 或 API 测试一个公开页面。
- 使用条件
- 持续使用需核对账户、凭证、额度和速率;受限内容不因使用接口而自动获得访问权。
可以完成哪些工作
按你的目标查看准备资料、操作方法和交付结果。
整理一套官方产品文档可用于后续检索的文档集合。
适合:知识库维护人员
- 准备什么
- 有权使用的文档站、版本路径和页数上限。
- 怎么完成
- 先发现目标路径的地址,筛掉历史版本与无关页,再抓取正文,保留标题、URL 和版本信息。
- 完成后得到什么
- 可用于后续检索的文档集合。
- 交付前检查
- 抽查代码块、表格和段落,地址发现成功不代表正文已完整提取。
提取候选产品规格结构统一的规格对照数据。
适合:采购研究开发者
- 准备什么
- 官方产品页清单、型号和统一字段模式。
- 怎么完成
- 先用单页样本调试字段,再逐页提取尺寸、接口和条件,缺失内容保留为空并附原链接。
- 完成后得到什么
- 结构统一的规格对照数据。
- 交付前检查
- 核对单位、选配项和不同型号,不能用页面营销文案替代确定参数。
盘点自有站点内容带页面地址的内容盘点表。
适合:网站编辑与维护者
- 准备什么
- 自有站点范围、目标路径和内容检查项。
- 怎么完成
- 生成页面地址清单,按限额读取正文与元信息,另写检查逻辑识别空内容、重复标题和需要更新的条目。
- 完成后得到什么
- 带页面地址的内容盘点表。
- 交付前检查
- 复查分页、重定向和抓取失败项,不能把未抓到等同于页面不存在。
如何使用 Firecrawl
- 选择接口与范围
说明需要搜索、读取还是发现地址,限定站点、路径和数量。
- 测试一个真实样本
检查正文、表格、字段与返回状态,确认结果适合后续任务。
- 配置批量与失败处理
核对额度和速率,保存任务状态、失败 URL 及可重试记录。
- 校验后再进入后续流程
抽查原网页,保留来源和缺失信息,再交给知识库或分析程序。
界面与操作参考
开始前需要了解
网页限制仍可能阻止读取
登录、访问策略、失效页面和动态内容都可能影响提取。
结构化结果仍需核对
字段可能缺失或误识别,应校验单位、类型和来源对应关系。
抓取范围影响成本
页数、操作类型和附加能力会影响消耗,避免不设边界地遍历站点。
账号权限、费用与可用功能请以官方入口的当前说明为准。重要结果应先检查,再用于实际工作。
常见问题
它会自动判断资料真假吗?
主要负责获取与整理网页,事实可信度和来源质量需要另行评估。
Map 和 Crawl 可以互换吗?
不能。Map 主要发现 URL,Crawl 才会处理范围内的页面内容。
输出 Markdown 就没有遗漏吗?
仍可能遗漏表格、脚本加载内容或特殊布局,重要材料应对照页面。
能用于自己的智能体吗?
可通过 API、SDK 或相应集成接入,需配置凭证、限额和错误处理。
从开源与本地工具角度评估Firecrawl
把开源与本地工具需要的条件列清楚,再比较工具。阅读本页的产品用途、步骤与限制,再逐项确认下面的问题;这些是选型方法,不表示每款工具都具备同样能力。
本地运行到哪一步
区分本地界面、本地处理和外部API;不能只看名称判断数据去向。
环境是否匹配
检查系统、内存、磁盘和依赖,按官方要求判断能否运行。
后续是否可维护
确认许可证、配置保存、数据导出与版本更新方法。
选择一个小样任务,先检查结果与交付格式,再决定是否用于更多资料。